ИИ-агент для HR-сервиса: как подключить внешнюю LLM и не выпустить наружу чувствительные данные
В статье расскажу, как спроектировала и реализовала ИИ-помощника для HR-сервиса компании. ИИ-помощник ищет ответы документам компании, базам данных, а также отвечает на общие, не относящиеся к работе вопросы. Работает по двухпроходной схеме с классификатором, при этом не передает чувствительные данные во внешнюю LLM.
Задача: добавить в HR-сервис ИИ-помощника
Заказчиком задачи был HR-отдел. Коллеги просили добавить в ИИ-помощника в существующий HR-сервис. Основной целью было повысить лояльность сотрудников: предоставить поддержку касательно внутренних регламентов, упростить поиск по внутренним документам и справочникам, дать доступ к ИИ из внутреннего ресурса компании.
В результате обсуждения с HR сформировали требования:
- Поиск по внутренним документам компании. Сотрудник спрашивает «как оформить отпуск», «где взять бланк заявления», «какой порядок согласования обучения», и получает ответ на основе регламентов и справочных материалов.
- Поиск по подразделениям и сотрудникам. Чтобы человек мог найти почту и телефон отдела или сотрудника.
- Ответы на общие вопросы. Если сотрудник спрашивает что-то не про работу, например: «как приготовить блины», «столица Камбоджи» и др., то ИИ должен корректно отвечать на такие вопросы.
- Обращение к живому HR как запасной вариант. Если вопрос про работу, но ответа в документах нет, помощник предлагает написать HR-менеджеру через форму.
Ограничение: внешняя LLM и чувствительные данные
Генерировать ответы должна была внешняя LLM. А значит, всё, что пользователи отправляют в неё, физически уходит за пределы компании на чужие серверы. Важно было фильтровать или маскировать чувствительные данные, которые могут быть в запросах пользователей или в контексте для LLM.
LLM (Large Language Model, большая языковая модель) — это тип нейросети, обученной на огромных объёмах текста предсказывать следующее слово в последовательности.
Решение: развернуть RAG, фильтровать вход, часть запросов не отдавать LLM вообще
Всё, что уходит в LLM, предварительно обезличивается. В запросе пользователь может написать имя и фамилию сотрудника для поиска, а это персональные данные. Поэтому запрос пользователя проходит через фильтр, который находит имена и заменяет их на плейсхолдеры (NAME_1, NAME_2), прежде чем текст уйдёт в нейросеть.
Поиск контактов выполняется программно, вне LLM. Контакты сотрудников — самые чувствительные данные, и их нельзя отдавать вовне. Поэтому LLM здесь работает только как классификатор: она понимает, что человек ищет контакт, и возвращает HR-сервису команду выполнить поиск по справочнику. Сам поиск и выдачу контактов выполняет другая, не связанная с LLM программа.
Для документов разворачиваем RAG. Чтобы отвечать по внутренним материалам, я подготовила поисковый индекс. Документы и FAQ векторизуются и складываются в векторную базу. Если у пользователя вопрос по документам, то сначала в векторной базе находятся релевантные фрагменты, и потом передаются в LLM как контекст. Нейросеть отвечает строго по найденным документам.
FAQ (Frequently Asked Questions) — раздел с часто задаваемыми вопросами и готовыми ответами на них.
RAG (Retrieval-Augmented Generation) — технология, при которой языковая модель перед ответом ищет нужную информацию во внешней базе знаний и генерирует ответ на её основе. База — это обычно векторное хранилище, например, Qdrant. Исходные документы заранее разбиваются на небольшие фрагменты – чанки. Затем каждый фрагмент преобразуется в многомерный вектор с помощью специальной модели-эмбеддера. Все векторы сохраняются в базе. Когда пользователь задаёт вопрос, он тоже переводится в вектор, и система ищет математически близкие к нему векторы — то есть фрагменты, наиболее схожие по смыслу. Найденные фрагменты передаются языковой модели вместе с вопросом, и она формирует ответ, опираясь на них.
Подстраховка живым HR. Если вопрос корпоративный, но в документах ответа нет, помощник честно говорит, что не нашёл, и предлагает написать HR через форму обратной связи.
Для лояльности — отвечаем на все вопросы и генерируем картинки. Общие вопросы уходят в LLM как есть: в них нет корпоративных данных, обезличивать нечего, и она отвечает из общих знаний. Дополнительно добавила генерацию изображений — сотрудник может попросить «нарисуй кота», и агент сгенерирует картинку.
Источники данных
У агента три источника, откуда берётся ответ:
- Сама LLM — для общих вопросов, не связанных с работой. Здесь источник знаний — это обученная модель, корпоративный контекст не нужен.
- FAQ — таблица готовых пар «вопрос-ответ» в сервисе NocoDB. Ее ведет HR-менеджер. Сюда попадают частые вопросы, на которые нужен выверенный ответ.
- Документы (RAG) — регламенты, бланки, справочные материалы. Лежат в файловом хранилище, их метаданные — в табличном сервисе NocoDB. Содержимое индексируется в векторную базу Qdrant с помощью Open Source модели multilingual-e5-large.
FAQ и документы агент ищет одним запросом сразу по всем, не выбирая источник заранее — ответ может оказаться в любом из них.
Реализация: двухпроходная схема
На каждый вопрос агент по двухпроходной схеме решает, как ответить. Первый проход (Pass 1) — классификатор: выбирает инструмент – tool call. Второй проход (Pass 2) — формирует ответ.
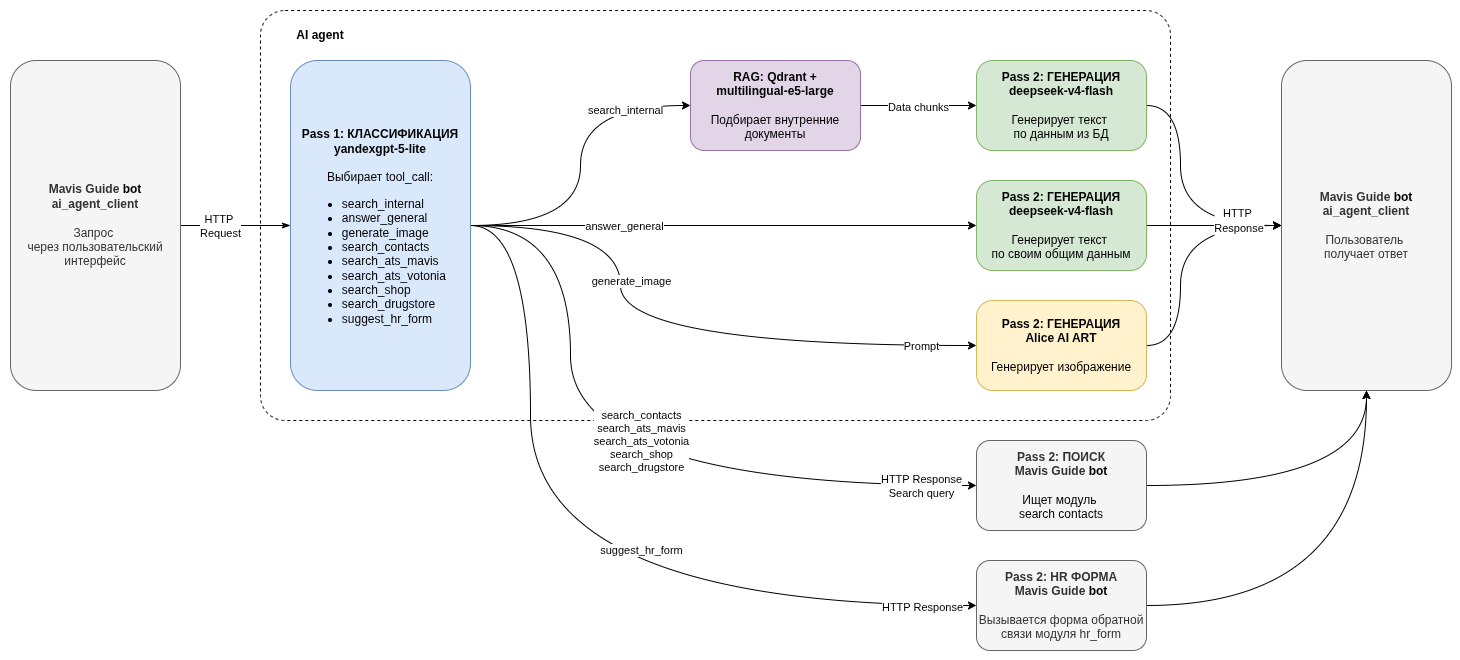
Тулколы, которыми может ответить классификатор на первом шаге:
- Поиск во внутренних источниках (search_internal) — ищет по подготовленной таблице FAQ, документам.
- Команда поиска (search_contacts, search_ats_mavis, search_ats_votonia, search_shop, search_drugstore) — агент возвращает инструкцию выполнить поиск по справочнику и передает строку для поиска. Далее поиск выполняется программно, без участия LLM.
- Общий ответ (answer_general) — если вопрос не про работу в компании, LLM отвечает из общих знаний.
- Изображение (generate_image) — генерирует изображение по тексту через Alice AI ART.
- Форма HR (suggest_hr_form) — если по корпоративному вопросу ничего не нашлось, агент предлагает обратиться к живому HR.
Контекст диалога через Redis
Для LLM каждый запрос новый, история автоматически не подтягивается. Чтобы помощник понимал уточняющие вопросы, например, «а где его найти?» после предыдущего ответа, нужна память о диалоге. Для этого история переписки пользователя записывается в Redis. Затем при каждом запросе история передается в Pass 2, чтобы нейросеть отвечала с учётом контекста.
Индексация документов
Корпоративные документы лежат в файловом хранилище, а поиск выполняется по векторной базе данных. Чтобы текстовые документы перевести в многомерные векторы, нужна индексация.
Индексация работает так. Администратор ведет в таблице NocoDB список документов, которые нужно проиндексировать, сами документы кладет в файловое хранилище. ИИ-агент забирает список документов, скачивает их из хранилища, а также получает FAQ. Далее индексатор проходит по записям FAQ и документам в хранилище, превращает текст в векторы и складывает все в Qdrant. Индексация инкрементальная: для каждой записи сравнивается дата изменения в NocoDB с датой, когда её проиндексировали. Если запись не менялась — пропускается.
Отдельно решается задача синхронизации: если запись удалили или переименовали в NocoDB, старый вектор нужно убрать из Qdrant, иначе накопятся «призраки» — ссылки на несуществующие документы. После цикла обновления индексатор сверяет, что реально есть в NocoDB, с тем, что лежит в Qdrant, и удаляет лишнее.
Архитектура
Схематично сервис устроен так:
.jpg)
HR-сервис – получает запрос от пользователя и обращается в ИИ-агента по HTTP на POST /api/v1/ask. Контракт между HR-сервисом и ИИ-агентом описан в docs/openapi.yaml.
Внешняя LLM — Yandex AI Studio как основной провайдер и GigaChat как запасной. LLM-клиент абстрагирован: чтобы перейти на другого провайдера, достаточно переписать один модуль-клиент, вся остальная логика остается нетронутой.
RAG — Qdrant как векторная база и локальная модель эмбеддингов multilingual-e5-large.
NocoDB – таблицы с FAQ и метаданными документов, сами файлы лежат в файловом хранилище.
Redis – хранит историю переписки с пользователями.
Стек технологий
- Python 3.12 — основной язык.
- FastAPI — веб-фреймворк для сервиса агента, с эндпоинтами и валидацией запросов и ответов через Pydantic.
- Qdrant — векторная база для RAG.
- Redis — хранение истории диалогов.
- multilingual-e5-large — локальная модель эмбеддингов для векторизации.
- Docker Compose — сборка и запуск всего стека.
Совместимость и развитие
Агент спроектирован так, чтобы отдельные части можно было заменить, не переписывая остальное. Например, провайдер LLM меняется переписыванием одного модуля-клиента. Бизнес-логика – классификация, RAG, обезличивание, не зависит от того, какая нейросеть под капотом. Векторную базу или модель эмбеддингов тоже можно поменять — они написаны в отдельном слое.
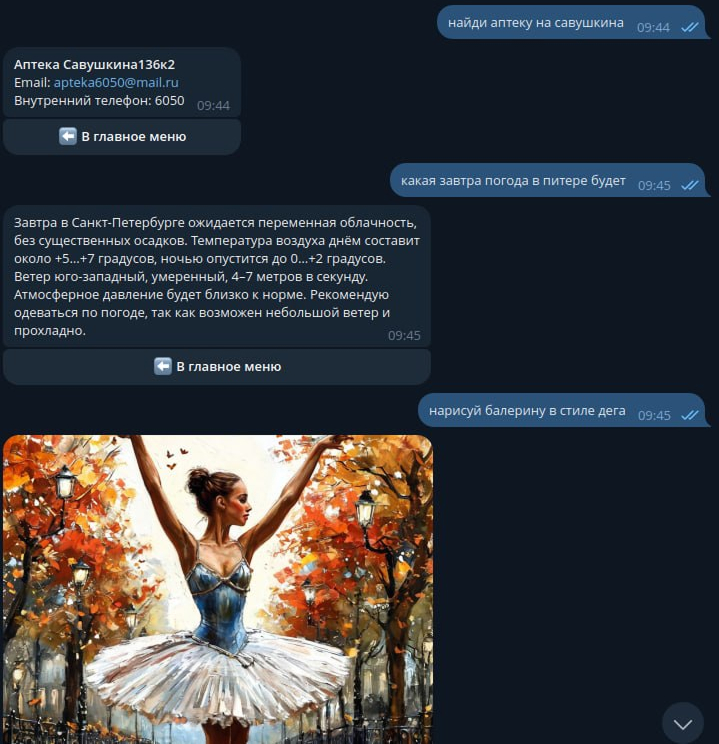
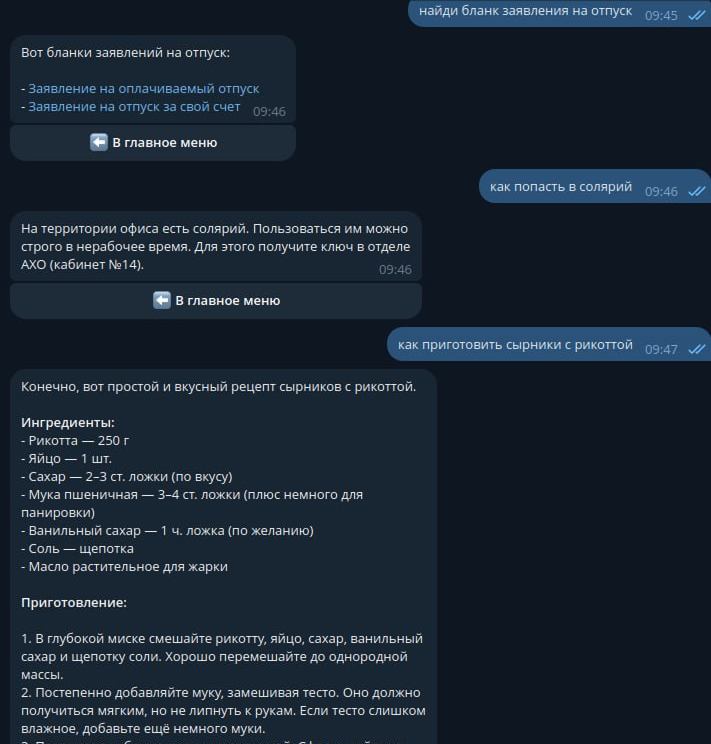
Демонстрация работы